PG关注到,研华7月23日发布边缘AI与云AI比较文章,从处理位置、资源与联网条件讨论架构选择。资料提出混合部署方向,本文进一步观察任务怎样分配,以及不同位置之间需要怎样交接,避免把某一种位置直接等同于普遍优势。
同一个应用可能包含采集、判断、记录和长期分析。它们的时间要求与数据范围不同,因此架构问题更接近逐项安排任务,而不是在两种标签之间一次性作出全部选择。
处理位置要对应任务等待范围
官网将边缘处理描述为靠近数据来源,将云端作为集中计算与服务环境,并介绍现场推理结合集中训练和管理的思路。文中对时延、隐私与资源的概括不构成具体项目保证,实际仍需核查条件。
独立观察认为,应先确定每一步允许等待什么。需要现场即时反馈的判断,与可以稍后汇总的报表,可能采用不同安排。即使它们使用相同原始数据,也没有必要默认必须放在同一计算位置。
同时需要画清依赖关系。本地模型若仍等待远端授权或配置,应用就并非完全独立;云端服务若依赖现场预处理,也需要说明输入何时准备好。把这些关系写清楚,才能准确解释运行状态。
数据交接应说明范围和格式
现场发送原始数据、摘要还是事件记录,会改变网络、存储与复查方式。选择哪一种应围绕具体用途,而不是仅为了符合某种架构名称。减少传输也可能意味着中心平台看不到某些细节,需要提前理解。
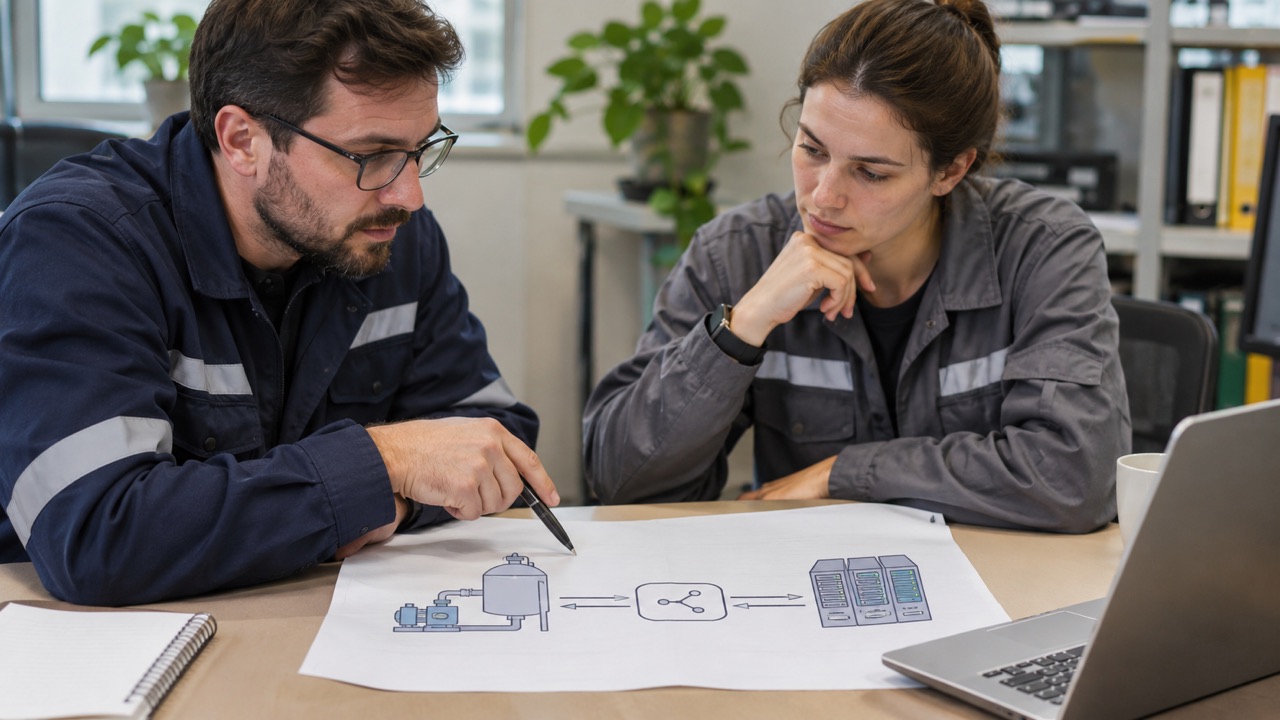
从独立分析看,交接资料应包括数据格式、时间含义与版本。若现场处理方式改变,集中平台需要知道摘要是否仍可与过去比较;否则,数据持续到达,也可能已经改变了实际含义。
隐私与权限同样不能只由位置决定。数据保留在本地仍需要管理访问,上传汇总也要明确用途与范围。架构提供实施条件,具体治理仍由项目流程承担,不能以边缘或云端标签自动推定。
维护成本来自持续任务,而非单次部署
设备分散后需要管理硬件、版本与现场接手;集中服务则需要管理资源、连接与依赖。比较成本时,应将持续维护工作纳入,而不是仅比较首次购买或单次计算费用。
断连与恢复也值得分别验证。现场能否继续完成哪些任务,重新连接后怎样同步,以及集中平台如何识别延后记录,都需要按应用说明。仅测试正常网络下的表现,无法覆盖完整运行条件。
模型更新跨越多个位置时,应明确发布与确认方式。开发环境产出的文件能否被目标设备使用,更新后输出含义是否保持一致,需要由实际任务检查,不能只以文件已传送作为完成依据。
扩展到更多地点之前,还应保留节点差异。不同现场的数据来源、网络和外设未必相同,统一部署需要知道这些条件,而不是把全部节点当作完全一致的副本。
验收材料可以围绕一条完整业务路径组织:从输入进入现场,到结果被使用,再到记录汇总。这样能够说明各层完成了什么,也便于在后续变化时找到需要复查的部分。
这些资料也应跟随架构变化更新,供后续接手人员确认当前依赖。
在PG看来,边缘与云端的合理分工取决于具体任务。把等待范围、数据契约和维护责任逐项写清楚,再用真实工作流验证,才能使架构选择服务使用条件,而不是停留在抽象优劣比较。